企业落地
企业上线 Agent 前,Agent 评测要跑几个任务、每个跑几次
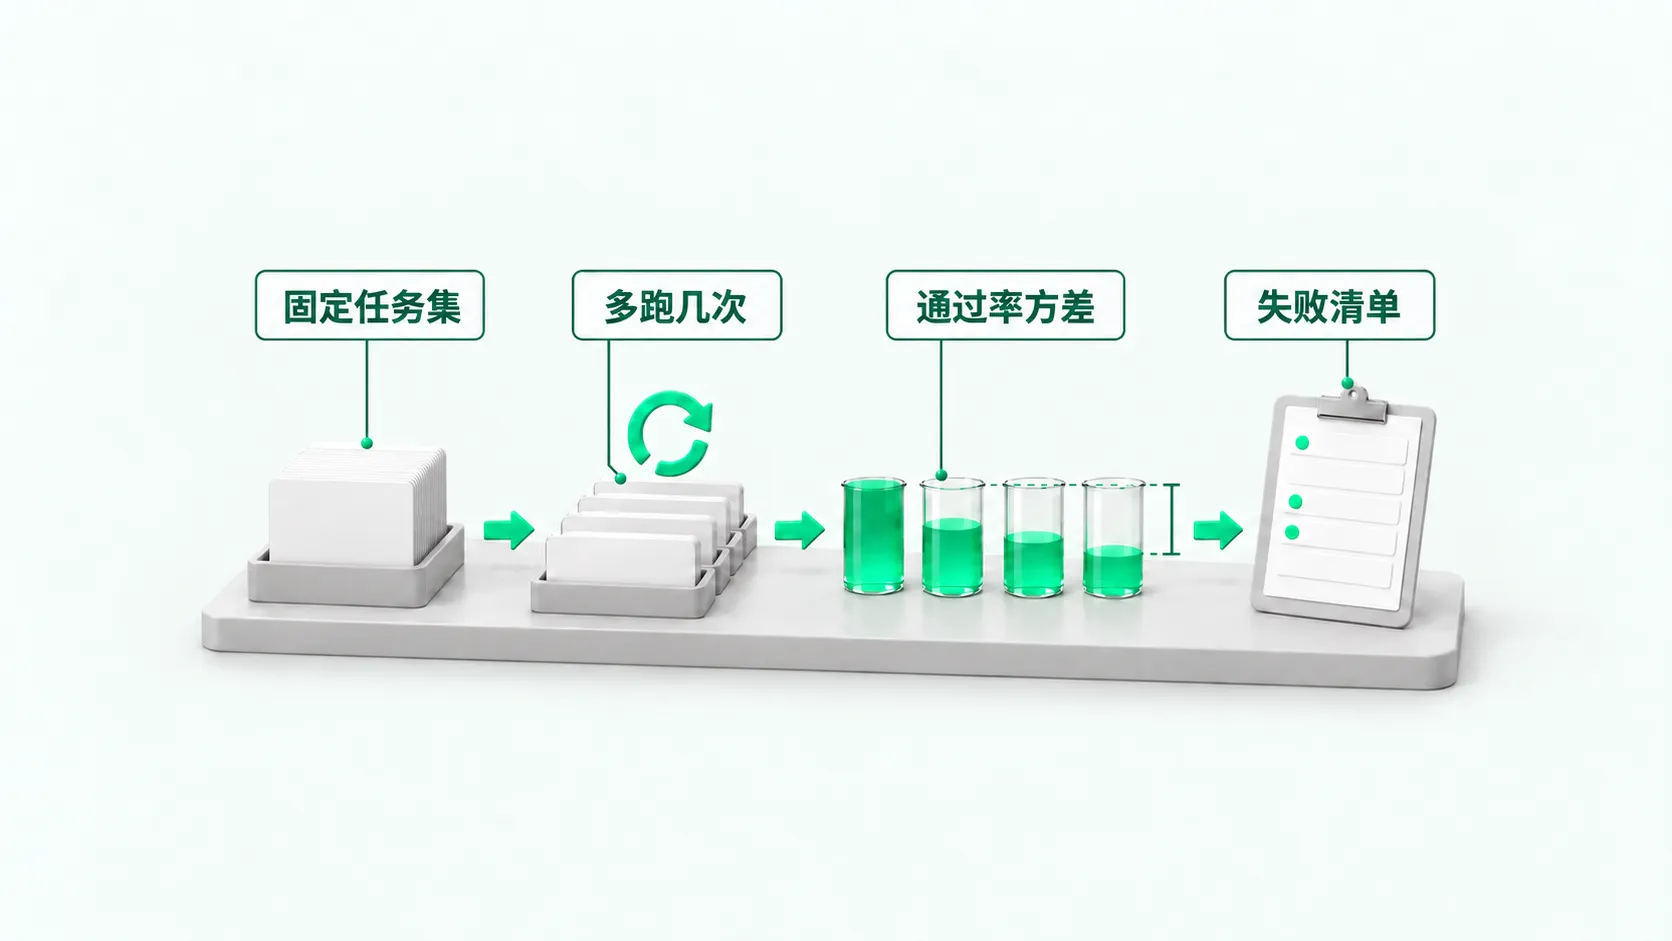
企业上线 Agent 之前,做 Agent 评测需要准备一组固定的真实业务任务,每个任务跑多次,统计通过率、单次成本、延迟和波动,并交出一份失败清单。只跑一次不能做上线依据,测试阶段要看多次运行的稳定性与边界。
Agent 上线前,用一组固定的真实业务任务做 Agent 评测,每个任务跑多次,报通过率、单次成本、延迟和波动,再写一份「它还做不到什么」的失败清单。只跑一次的结果不能拿来做上线决定。
任务集怎么挑:从真实业务里选,有明确验收标准
评测任务要从企业真实业务流程中提取,每个任务都具备清晰明确的完成标准。
任务集要梳理业务人员日常处理的真实工单、报表或客户诉求,覆盖常规主流程与易误判的边界情况。比如针对订单核对任务,既包含完整的标准单据,也放入缺字段或格式异常的问题单据,检验系统遇到异常时能否正确识别并停下。
密歇根大学 2026 年秋季课程 EECS 498-016《Applied Agentic Software Engineering》由 Marcus Darden 主讲,课程大纲写道:Agent 的评测套件至少包含 8 个任务,按通过率报告。8 个任务适合作为起步线,我们建议按业务面再加。测试数据准备见 Agent 接 CRM 之前,上线测试先跑模拟企业数据?。
课程大纲写道,课程坚持用学生自己部署的小模型,理由是小模型会把粗糙的工程明显暴露出来。我们的理解是:大模型常能猜对含糊的指令,小模型遇到歧义或格式错误更容易直接失败。企业评测时换一个较小的模型跑一遍,能提早发现提示词和工具定义的毛病。
每个任务跑几次:同一任务跑多次,观察运行波动
同一个模型处理同一个业务任务,多次运行的执行路径与产出结果并不完全一致。
大模型生成存在随机性,单次执行成功可能只是偶然绕过歧义,后续重试可能在同一处卡死。仅凭跑通一次就判定就绪,上线后容易在常规业务中突然中断。
课程大纲写道,每个任务至少跑 3 次,并按通过率报告。原帖介绍这门课的推文下,一条回复提到从业者经验:每个任务只跑 3 次,一次超时通过率就掉 33%;回复者建议至少跑 10 次并观察方差。
我们建议企业开展评测时,核心任务测试次数至少提升到 10 次。多轮执行能滤除偶发抖动,暴露模型在特定提示词下的不稳定倾向。团队除了看综合得分,还要观察同一任务在不同轮次中的执行差异。
评测结果报哪四个数:通过率、单次成本、延迟与波动
验收评测套件时,团队需要汇总四项客观数据:通过率、单次成本、延迟和波动。
课程大纲列出的评测讲题,明确包含了任务集、通过率、成本和延迟。
第一项是通过率,即每个任务在多轮运行中顺利完成的比例。完成与否由业务规则或校验脚本判定,不能由模型自我评估。
第二项是单次成本。我们建议单次成本算上重试和失败的那几次轨迹。在自动化作业中,Agent 遇到报错常会重试并消耗 Token。把失败重试的开销摊进任务成本,算出的预算才符合实际。
第三项是端到端延迟,记录从任务触发、工具交互到最终结案的完整耗时。
第四项是波动。多次运行的时间、消耗和结果差异,反映了流程的稳定性。若同一任务有的轮次耗时几秒、有的轮次跑满超时上限,说明决策逻辑存在分叉风险。
失败清单:写清 Agent 还做不到什么
验收交付时还需要提供一份明确的失败清单,拆解系统当前做不到的具体事项。
课程大纲写道,在 Analyze 阶段最后交一份拆解报告,写清楚 Agent 还做不到什么,并按找到的失败质量打分。
在企业落地中,许多失败往往发生在边界细节上。比如:处理客户询价单时,文本一旦出现生僻计量单位,工具调用就会报错;或者多表比对时行数超出预设窗口,模型遗漏末尾数据。将这些已知问题写进清单,业务人员就能清楚系统在哪些边界上不能独立处置。
我们建议企业在验收内部成果或供应商方案时,将这份「做不到什么」的失败清单作为必备材料,提前在边界处布设人工介入点。
上线前测试与上线后指标的分工
上线前的评测套件用于确定能力基线与验收门槛,上线后则转入业务价值的长期跟踪。
上线前的 Agent 评测聚焦在固定输入下的确定性表现:任务能否做对、多跑几次稳不稳、单次成本和耗时是多少。这阶段建立的测试基线,是后续每次改版的对照组。
系统部署到生产环境后,重点转向端到端的业务价值。Agent 上线后追踪工单结案率与成本收益的具体评估方法,见 Agent 上线后,效果评估该看哪几个数。
挑选第一批落地场景时,先挑结果能当场验证的任务,见 AI 落地场景先挑哪类?先看结果能不能当场验证。这类场景的结果容易比对,上线前的评测集好建,上线后的自动验收也更顺。
Agent 评测:常见问题
为什么评测时用能力较弱的小模型,反而更容易暴露工程问题?
小模型对提示词表达的歧义、工具入参的格式偏差以及上下文环境更加敏感。大模型往往能凭借更强的推理能力,自动补全不严密的指令或猜测缺失的字段,掩盖了底层工程漏洞。如果在小模型环境下,系统能够依靠精确的工具定义、输入检查与清晰的停止条件稳定运行,说明工程这一层已经站得住。这是我们的判断,课程大纲只写了它用小模型的理由。
评测套件全部通过后,为什么生产运行仍可能出现意料之外的失败?
评测套件是在受控的已知数据集上运行,覆盖的是团队已经识别出的常见路径与边界条件。真实生产环境中,外部系统接口变更、客户输入未曾预料的非标格式以及底层网络抖动,都会产生未纳入测试集的异常输入。因此评测套件是通过验收的准入门槛,生产环境依然需要配合日志审计、额度上限和人工复核共同运作。
团队在统计测试表现时,为什么要看通过率方差?
只看平均通过率容易掩盖运行的不稳定性。比如两个任务的平均通过率相同,一个是每轮测试都稳定完成大部分步骤,另一个若干轮拿满分、若干轮由于工具陷入死循环而彻底失败,两者的通过率方差差别很大。通过率方差能够量化系统在多轮执行中的离散程度:方差偏高通常说明当前提示词或重试逻辑存在随机缺陷。将通过率方差纳入统计,能帮助团队在上线前找出这类时好时坏的脆弱分支。